Presentación: Estimación de Eventos de Extinción Masiva
Haz clic en la imagen para ver el PDF de la presentación
Estimación de Eventos de Extinción Masiva con treepar en R
La extinción masiva es un proceso clave en la evolución de la biodiversidad, marcando periodos en los que un gran número de especies desaparece en un corto intervalo de tiempo. La detección de estos eventos en filogenias permite inferir patrones históricos de diversificación y evaluar cómo la biodiversidad ha respondido a cambios ambientales y evolutivos a lo largo del tiempo.
El enfoque de treepar se basa en la estimación de tasas de especiación (\(\lambda\)) y extinción (\(\mu\)) a lo largo del tiempo en una filogenia dada. La función clave, bd.shifts.optim, utiliza métodos de máxima verosimilitud para encontrar los puntos en el tiempo en los que estas tasas cambiaron significativamente. Al habilitar la opción de extinciones masivas (ME = TRUE), el modelo permite detectar periodos en los que la tasa de supervivencia de las especies disminuyó abruptamente, lo que puede indicar una extinción masiva.
Cargar librerías y el árbol filogenético
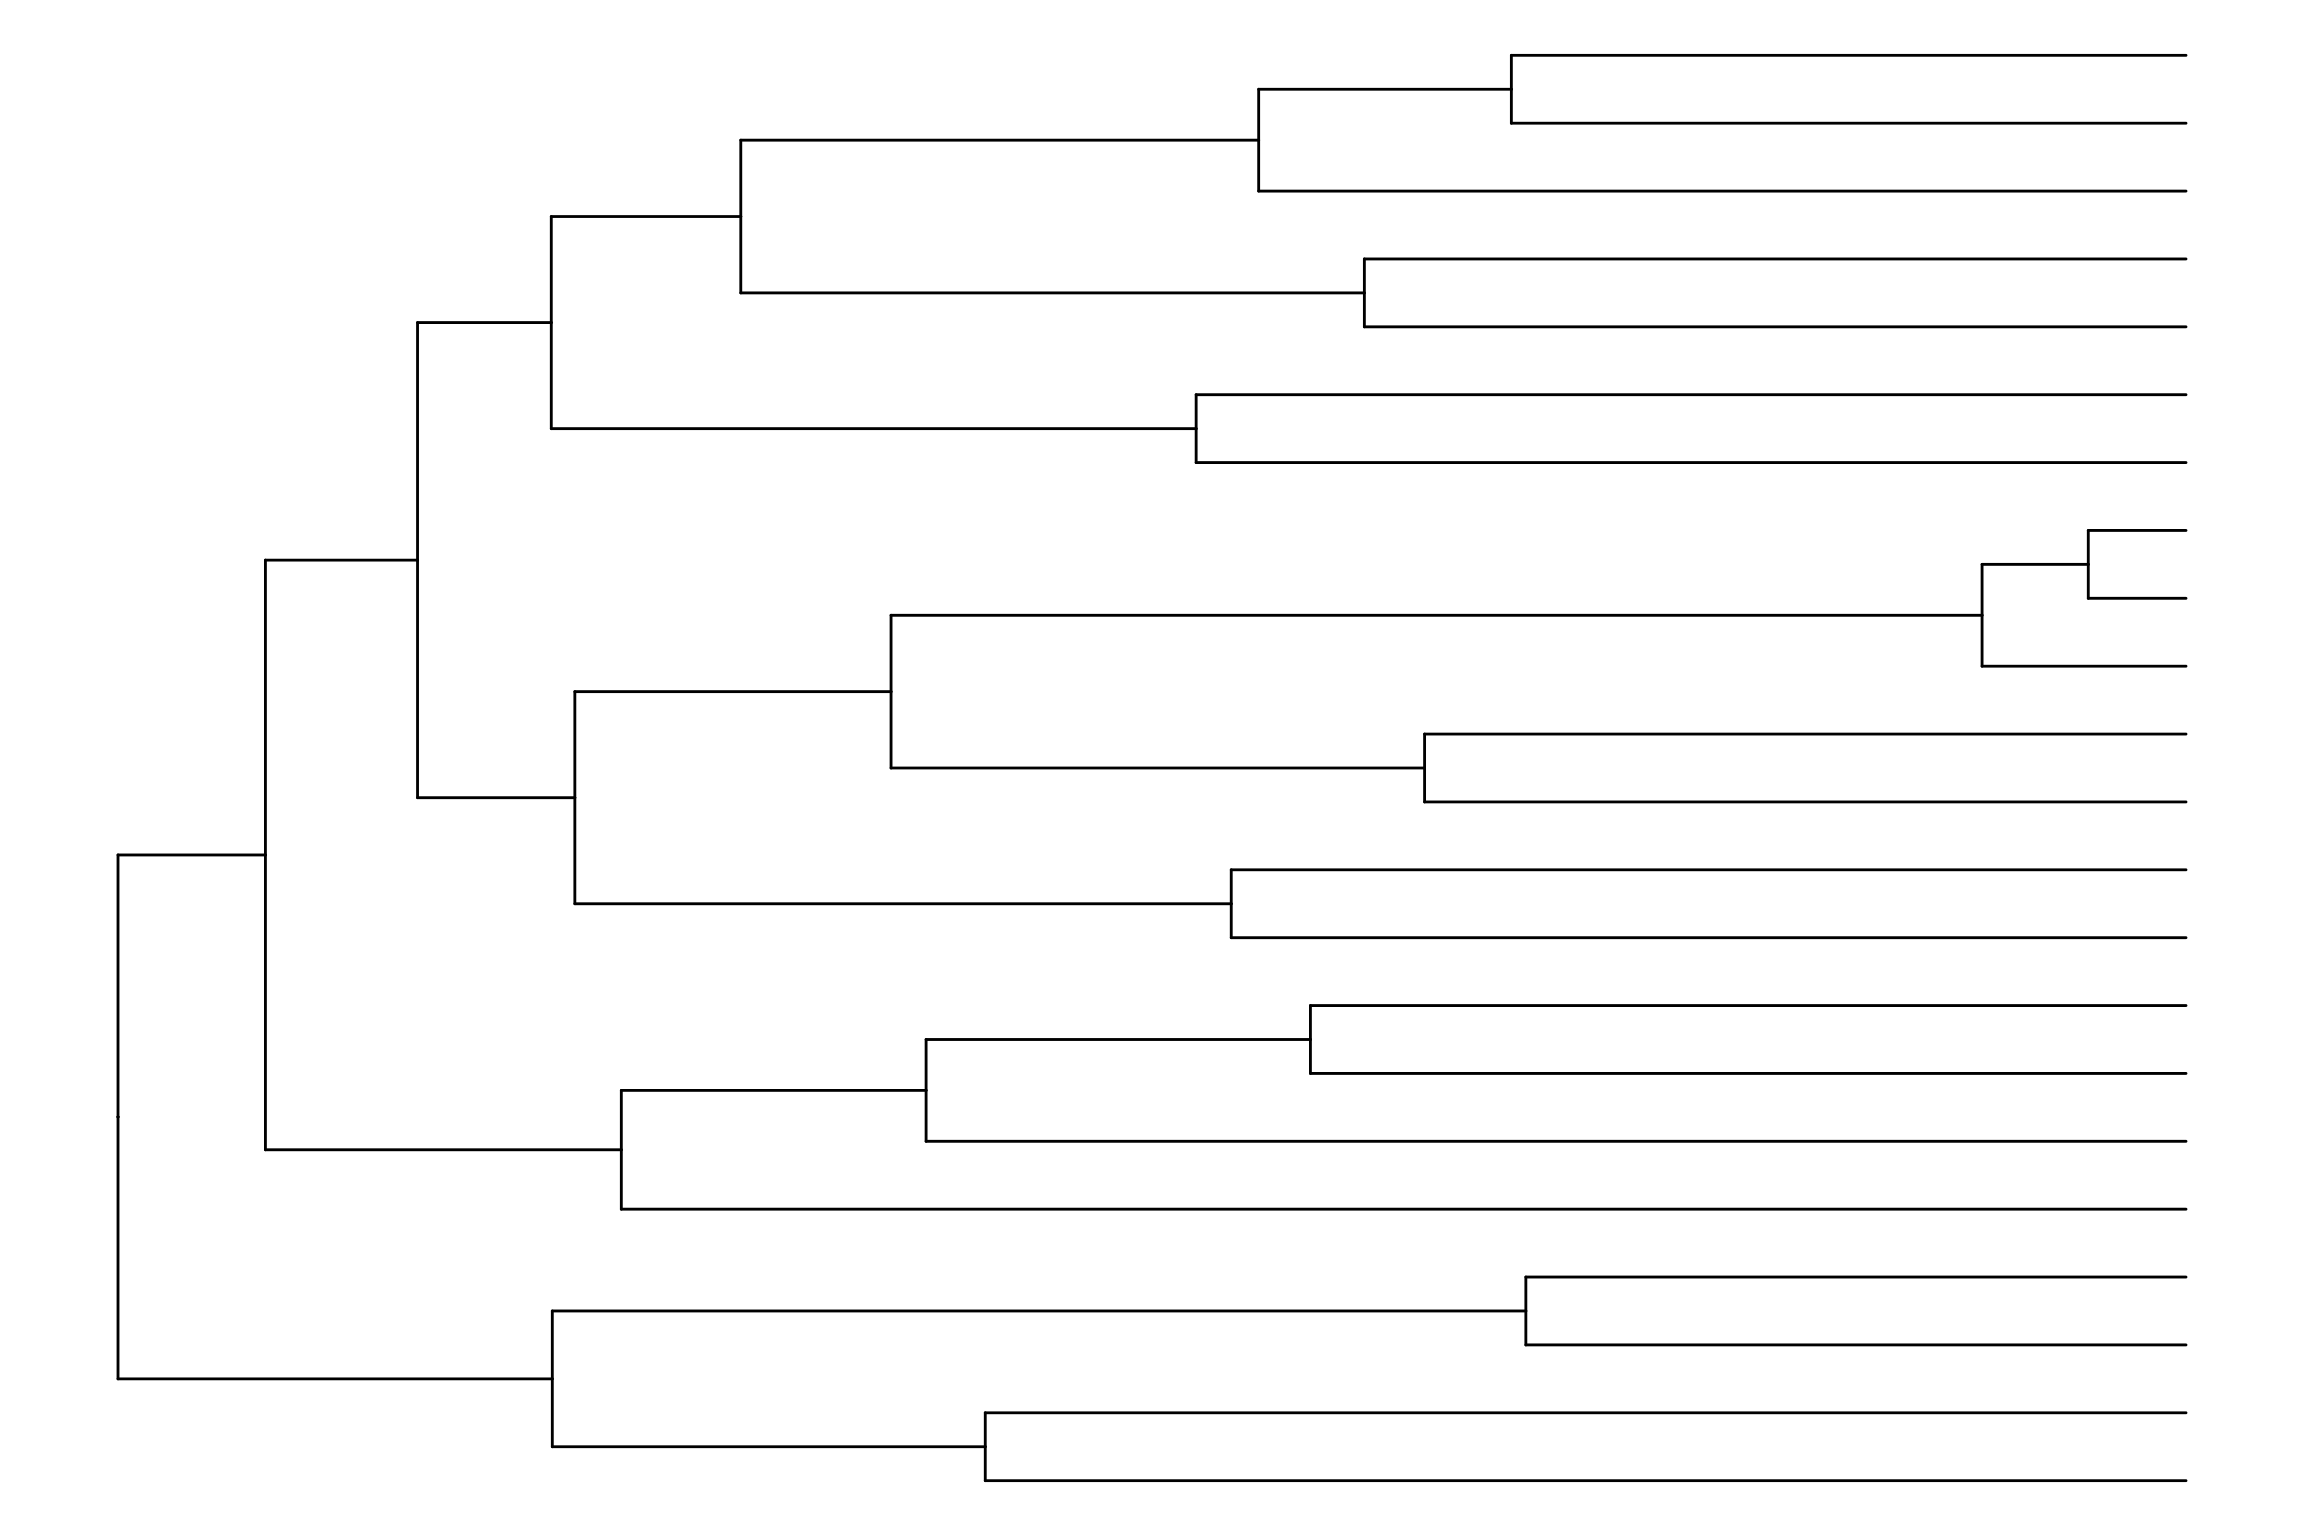
# Cargar las librerías necesariaslibrary(ape) library(TreePar)library(tidyverse)library(ggtree)# Cargar el árbol desde un archivo Nexustree <-read.nexus("../docs/u1_PatDiv/subarbol_ingroup.nex")# Visualizar el árbolggtree(tree) +theme_tree()
Obtención de los tiempos de diversificación
Extraeremos y ordenaremos los tiempos de diversificación (tiempos de ramificación) del árbol:
# Obtener y ordenar los tiempos de especiación# La función getx() extrae los tiempos de ramificación del árbol.times <-sort(getx(tree), decreasing =TRUE) # sort () rdena los tiempos en orden descendente.times <-unname(times) # elimina los nombres de los elementos del vector para simplificar su manipulación.print(times)
Definiremos los parámetros necesarios para el análisis de cambios en las tasas de diversificación:
rho <-22/26# Proporción de especies muestreadas (22 de 26 especies)grid <-0.2# Tamaño de la grilla de búsqueda de cambios de tasa (en millones de años)start <-min(times) # Tiempo inicial para la búsqueda de cambios de tasaend <-max(times) # Tiempo final para la búsqueda de cambios de tasa
Modelo con un Evento de Extinción Masiva
# Ejecutar la optimización con detección de extinción masivares_MEE <-bd.shifts.optim(times, c(rho, 1), grid, start, end, ME =TRUE, survival =1) # Activar detección de extinciones masivas
Esto representa cuánto mejor se ajusta el modelo con 2 eventos en comparación con el modelo con 1 evento.
Grados de libertad = 2
Se obtiene de la diferencia en el número de parámetros entre ambos modelos (6 - 4 = 2).
p-value = 0.8819704
El p-valor es alto (\(>0.05\)), lo que indica que NO hay evidencia suficiente para preferir el modelo con 2 eventos de extinción sobre el modelo con 1 evento.
Esto sugiere que el modelo con 1 evento de extinción es suficiente para explicar los datos, y agregar un segundo evento no mejora significativamente el ajuste del modelo.
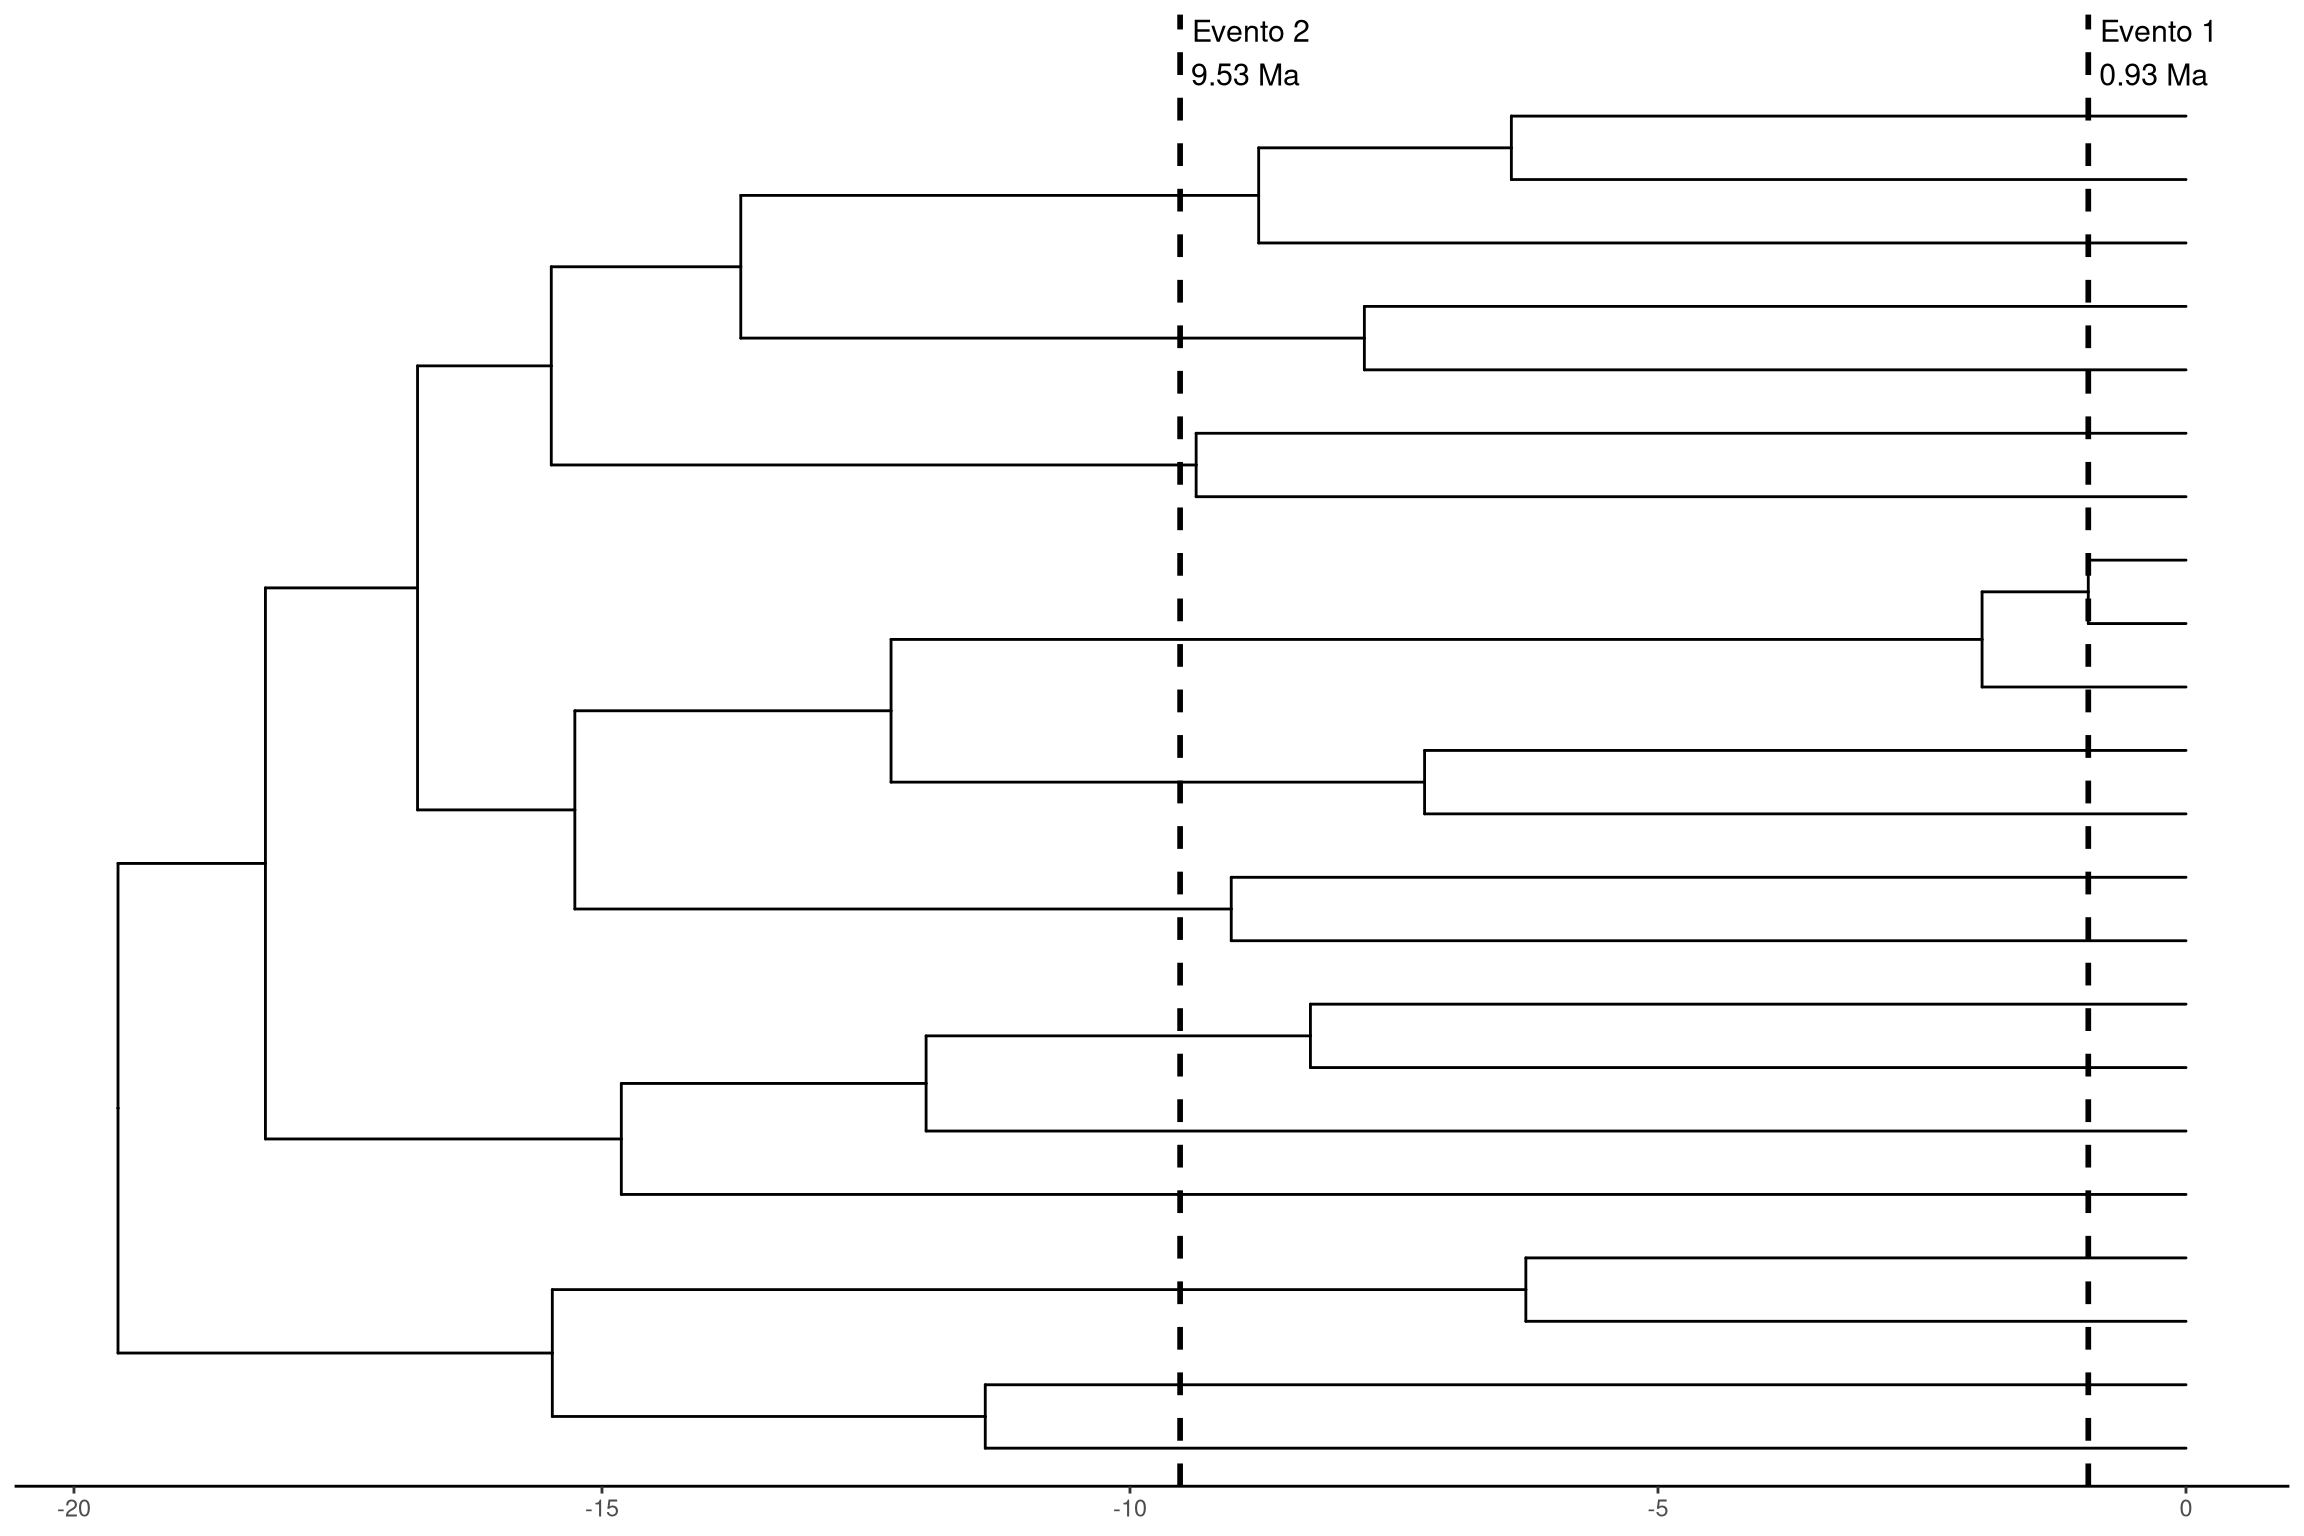
# Edades de los eventos de extinciónt0 <-0.9252293t1 <-9.525229# Construir el árbolp <-ggtree(tree)# Transformar la escala:# presente = 0; pasado = valores negativosp <-revts(p)# Graficar los eventosp +geom_vline(xintercept =c(-t1, -t0),linetype ="dashed",linewidth =1 ) +annotate("text",x =c(-t1, -t0),y =Ntip(tree) +1,label =c("Evento 2\n9.53 Ma","Evento 1\n0.93 Ma" ),hjust =-0.1,size =4 ) +theme_tree2()